我的观点是:工作流的自动化,至少要同时覆盖问题拆分、任务执行、知识管理这三个方面,而且它们之间要能形成闭环。
起点其实是个很具体的问题:我发现单纯在 markdown 里做 TODO 管理,已经承接不了复杂任务。它适合记想法和结论,却装不下任务状态、依赖关系、协作过程和中间决策;而这些过程信息虽然对推进任务很重要,任务结束后又大多不值得直接沉淀进长期知识库。
所以我最后的判断是:要把个人工作流做成自动化闭环,就得把问题拆分、任务执行、知识管理分开设计,再重新接起来。我最近把 Brains 接进 Multica 之后,这个判断变得更具体了:Multica 负责拆问题和组织协作,agent runtime 负责执行,Brains 负责提炼和回写知识,三者正好接成一条闭环链路。
flowchart LR
    A[问题 / 想法] --> B[Multica
    拆分成 issue / project]
    B --> C[Agent Runtime
    执行任务]
    C --> D[任务过程
    comment / log / 决策]
    D --> E[Brains
    提炼 / ingest]
    E --> F[可复用知识]
    F -.query.-> B
顺着这个判断往下看,这条链路其实就分成三段:Multica 怎么理顺问题拆分,agent runtime 怎么接住执行,Brains 又怎样把经验变成可复用知识。
Multica 先把问题拆分这件事理顺了
我对 Multica 最感兴趣的地方有两层。第一层是它作为 kanban 工具本身就很合适。既然我已经决定把任务管理从 markdown 里拆出来,就需要一个天然适合表达任务状态、依赖关系和协作过程的地方。Multica 在这件事上几乎不用怎么拐弯:issue、comment、project、repository,以及 parent/sub issue 这些元素,本来就是复杂任务管理需要的基本结构。
第二层才是更关键的地方:它不只是个看板工具,还把 agent 直接编进了任务流。也就是说,它不仅能管任务,还把 agent 设计成了任务系统里的正式成员,而不是挂在聊天窗口后面的隐藏能力。
这件事很关键。很多 agent 产品本质上还是“人发一句话,系统跑一段流程”。任务、责任、上下文都埋在一次次对话里,后续很难追踪,也很难复用。Multica 换了一个入口:issue、comment、assign。你可以直接把 issue assign 给某个 agent,让它开始处理;也可以在讨论过程中随手 @brains、@planner 或其他执行 agent,让不同 agent 进入同一个任务线程。
这样一来,agent 成了一个可以被分工、被协作、被追踪的角色。对复杂任务来说,这比“模型能力再强一点”更重要,因为团队真正缺的往往不是单轮回答,缺的是可持续的协作结构。
这一步首先解决的是问题拆分和任务组织:一个复杂问题怎么被创建成 issue,怎么继续拆分,怎么被分配,怎么在同一条线程里持续推进。尤其在异步、跨项目、多 agent 协作的场景里,这一点更有价值。没有这一层,所谓 agent 自动化大多只是单点能力调用,而不是完整工作流。
Multica + agent runtime 再把任务执行自动化接上去
Multica 的第二个吸引点,是它没有试图从零发明一套新的 agent 执行环境,而是通过 daemon + runtime 把已有工具串起来。
我会把它理解成一种更实用的 BYOA:bring your own agent。你可以把已有的 agent runtime 接进 Multica,让任务分配到具体 runtime 上执行。这样做有两个直接的好处。
- 第一,执行环境天然是分布式的。任务可以落到某一台具体主机上的具体 runtime 上运行,而不是都挤在同一个中心化服务里。
- 第二,已有的 agent 工具链可以直接复用。某个 runtime 本地有什么 skills、MCPs、CLI、沙盒能力,就能在执行时直接使用,不需要为了接入平台再重写一遍。
我会觉得它更靠谱,因为它最后落到的就是两个稳定接口,而且这两个接口刚好能把调用关系接成一个闭环。
- application -> daemon -> agent runtime:任何应用如果想利用 agent 的能力,只要能通过 daemon 接上 agent runtime,就能把任务交给已有的执行环境处理。
- agent runtime -> tool -> skill/cli:任何 agent runtime 如果想利用外部应用的能力,只要那个应用提供了 tool、skill 或 CLI 入口,runtime 就能直接调用它。
这两个方向一旦同时成立,Multica、Brains 和 agent runtime 就不再是孤立的点。你可以从任何一个应用出发去调用另一个应用的能力,也可以把它们继续串成串联、并联甚至网状结构,慢慢长出新的产品和能力。
flowchart LR
    subgraph Application
      A1[Application: Multica]
      A2[Application: Brains]
    end


    subgraph R[Agent Runtime]
        ReAct --> T[Tool]
        ReAct --> S[Skill]
    end

    D[Daemon]

    Application --> D
    D --> R
    T --> C[Bash CLI]
    C --> Application
我很喜欢这层抽象的原因,是它足够轻。只要工具本身边界还算清楚,往往不需要重做平台;补齐 daemon、CLI、skill 这些接口,就能把已有工具快速接进 agent 工作流。
Brains 补上的是知识管理自动化
只有任务系统还不够。Agent 可以执行,不代表它知道该怎么执行;Agent 可以解决一次问题,不代表这次经验会以正确的形式留下来。
这也是我把 Brains 接进 Multica 的原因。
Brains 本质上是我自己搭建的 llm-wiki。我给它做了命令行入口,也就是 Brains CLI,把知识库的读取和写入整理成 agent 可以稳定调用的接口。
然后我在 Multica 里创建了一个 brains agent,把这套 Brains CLI 的调用方式、适用场景和回复结构声明清楚。这个 agent 只做两件事:query 和 ingest。这样一来,Brains 成了任务流里随时可以被调起的知识角色,而不只是一个静态文档库。
这里补上的,不是“多一个知识工具”,而是知识管理自动化。任务执行过程中天然会产生很多过程式知识,但其中大部分并不具备长期沉淀价值。比如:
- 某一步命令的临时输出
- 一次失败的尝试
- 为了确认上下文而发生的来回讨论
- 针对当前环境做出的临时判断
这些内容对任务当下很重要,所以应该被 issue / comment / log 完整承接;但如果不经过筛选就直接写进 llm-wiki,知识库很快会失真。Brains 要做的,正是把这些过程材料筛成真正值得保留的结论、经验、约束和证据,再压缩成可复用的知识页。
这样,“问题拆分 -> 计划讨论 -> 受控执行 -> 经验编译 -> 知识沉淀”就被串成了一个闭环。
flowchart TD
    subgraph Task[任务域]
        I[Issue]
        C[Comments]
        L[Logs / POC / 决策]
    end

    subgraph Knowledge[知识域]
        S[总结 / 提炼]
        P[Brains Pages]
        Q[Query]
    end

    I --> S
    C --> S
    L --> S
    S --> P
    P --> Q
    Q -.回到新任务.-> I
一个很具体的 use case
比如我创建一个 issue:why kubernetes pod crashed。
接下来的协作可以非常自然:
- assign 给
@brains,先从知识库里找相关 runbook、排查经验和过去案例,列出初步建议。 - 在 comment 里
@planner,让它把排查动作拆出来,说明哪些步骤只读、哪些步骤有风险、哪些地方需要我确认。 - 再交给对应的执行 agent (如
@devops),在我确认以后执行需要落地的动作。 - 最后
@brains总结这次事件,把过程和经验写回 Brains。
这个流程最有价值的地方,是它把排查这件事变成了可协作、可回放、可筛选、可积累的过程。过去很多运维经验都死在聊天记录、终端历史和人的记忆里;现在它可以先作为任务资产被完整保留,再作为知识资产被有选择地沉淀下来。
从业务视角看,这其实是两个天然分开的领域
写到这里,其实也更清楚了:任务管理和知识沉淀同样重要,但不该被混成一个系统。
- 任务系统关注推进:谁来做,做到哪一步,讨论过什么,决定了什么,执行结果是什么。它天然容纳过程信息,而且过程越完整越好。
- 知识系统关注压缩和复用:哪些结论值得保留,证据链是什么,置信度如何,未来谁还能复用。它天然要反过程化,而且越精练越好。
如果直接把任务内容当知识,结果通常是双输:知识库被过程噪音淹没,任务系统也会因为过早压缩而失去上下文保真。
所以我更愿意把它理解成 agent 时代的 jira / confluence 分层:前者管理推进,后者管理知识。Multica 和 Brains 的组合,刚好把这两个领域重新接了起来,而且它们之间还能通过 agent 自动流动。
这套模式为什么真的改变了我的工作流
我现在越来越倾向于把 Multica + Brains 看成一个平台模式,而不是两个工具的偶然组合。原因不复杂:它把三个自动化层次刚好扣上了:
- 问题拆分层:Multica 用 issue、comment、assign 组织协作关系,把复杂问题拆成可推进的任务。
- 任务执行层:Multica 配合 daemon + runtime,把已有 agent runtime、安全边界和本地能力接进来。
- 知识管理层:Brains 把检索、编译和沉淀接进同一条任务链路。
这三层结合以后,agent 才不再只是执行器,而会以团队成员的身份参与任务推进,并在任务结束后帮助我把经验转换成真正可复用的知识。
我尤其看重的是它的扩展性。只要接口保持稳定,这个模式就能继续复制到更多场景:
- 给任何外部系统补一层 CLI + skill,agent 就能比较低成本地学会调用它。
- 给任何 agent runtime 补一层 daemon 接入,产品就能比较低成本地拥有 agent 执行能力。
- 给任何复杂任务补一层 issue/comment 协作结构,人和 agent 就能在同一条线程里沟通,而不是来回切换工具。
从工程实现上看,这比“先设计一个超级智能的大一统平台”更靠谱,因为每一层都能独立演进,也能单独替换。对我自己来说,变化也很实际:以前任务管理、agent 执行、知识沉淀是三件分开的事;现在它们第一次被接成一条链,而且不再需要我手动搬运,而是可以由 agent 在明确边界内持续推动。
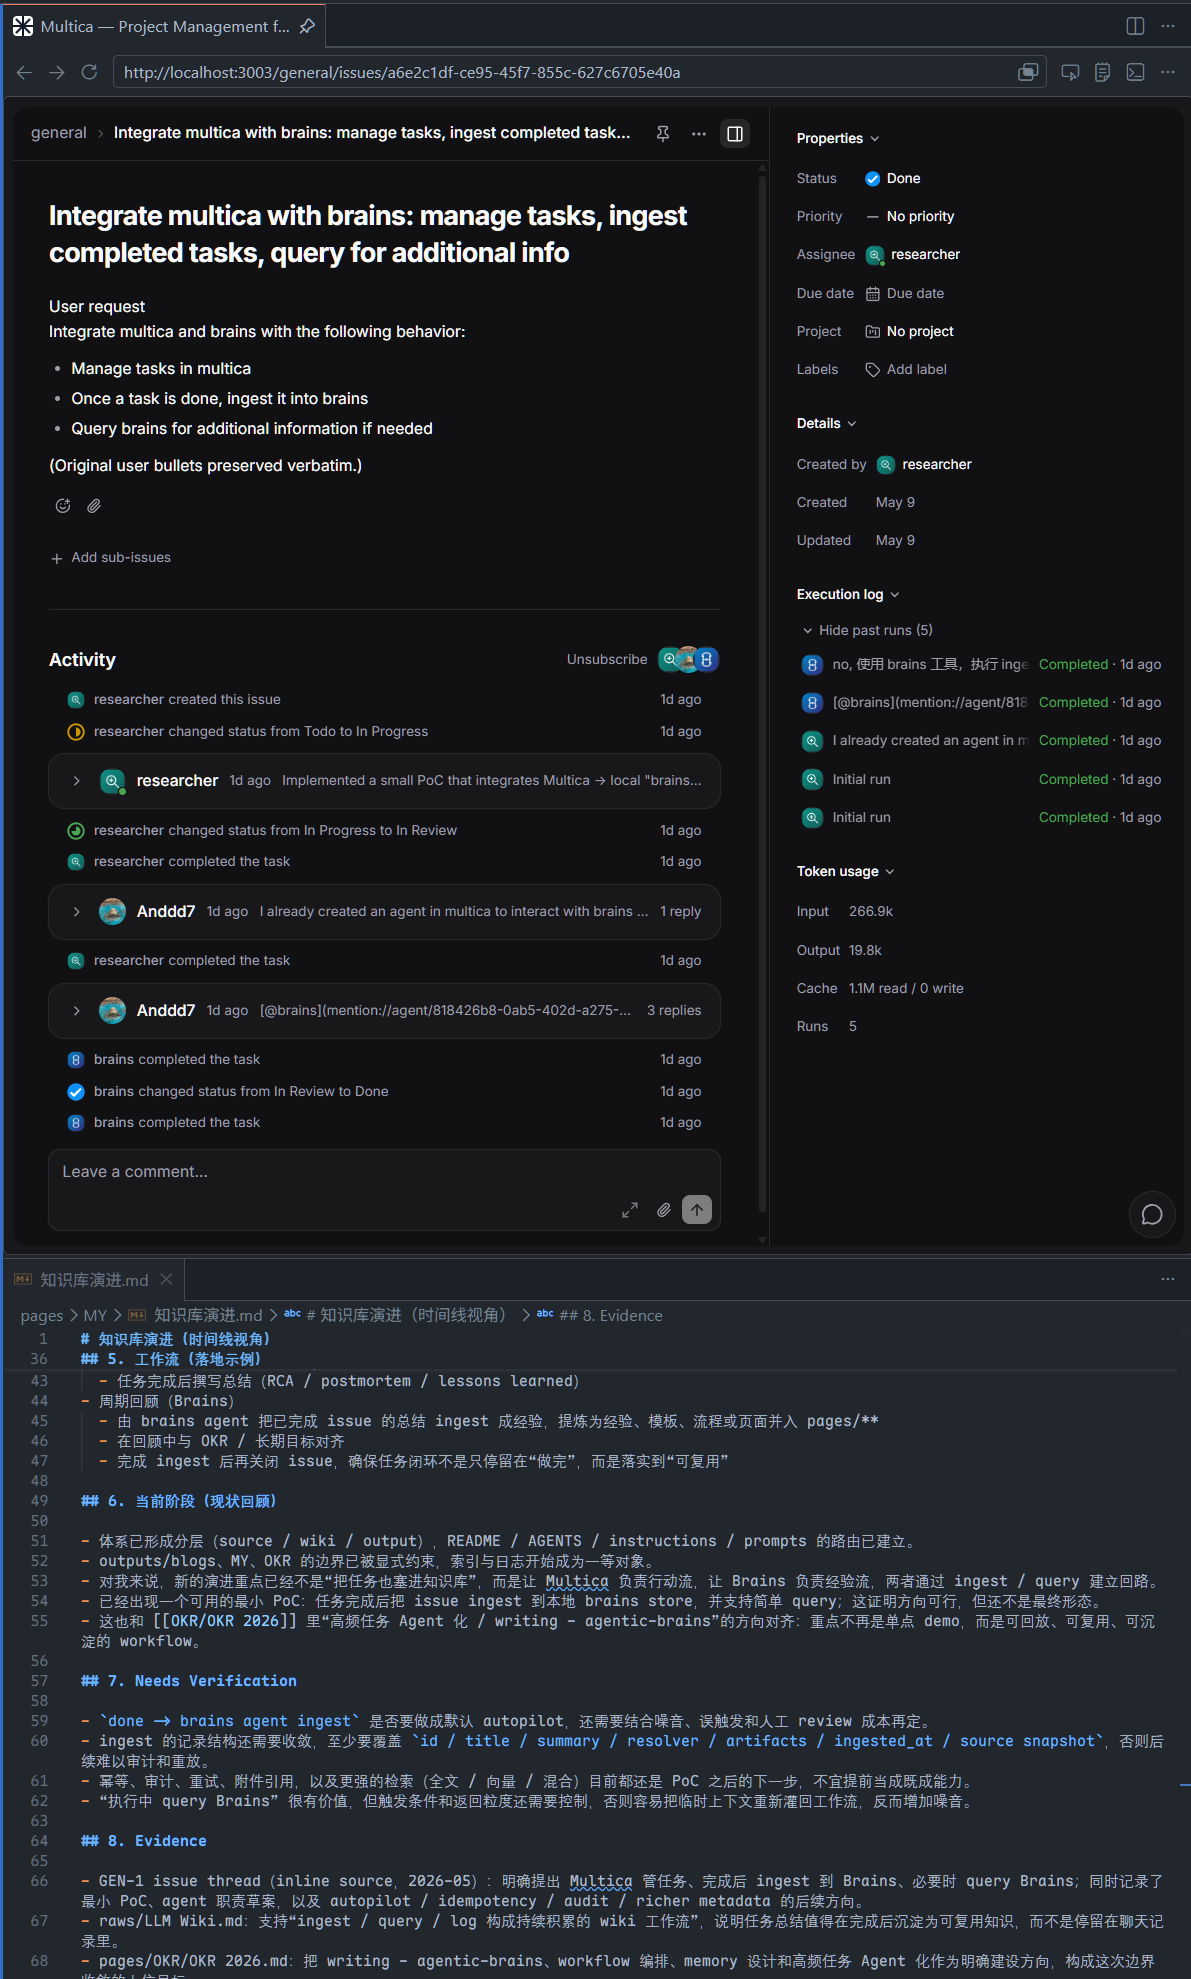
还没解决的问题
这套模式已经很有吸引力了,但还有几件事需要继续验证。
- 权限边界怎么做得更细。
planner只读、devops可写这种角色分层很有用,但再往下走,还需要更明确的审批、审计和回滚设计。 - 知识回写的质量怎么保证。 不是每一次 issue 处理过程都值得进入长期知识库,Brains 还需要更清晰的筛选和编译规则。
- 跨 agent 协作怎么避免噪音。 agent 越多,comment 和 sub-issues 越容易膨胀,平台需要更好的路由、去重和收束能力。
这些都不是小问题。但它们恰好说明,这条路值得继续走:因为真正有价值的平台问题,通常都发生在“已经能跑起来”之后。
结尾
如果只把 agent 当成一个更聪明的聊天对象,我们得到的大多还是局部效率提升;但把它放进任务系统、运行时系统和知识系统的交叉点里,它才可能真正成为团队协作者。
对我来说,Multica 解决的是“怎么让 agent 进入任务流”,Brains 解决的是“怎么让经验留下来,并在下一次任务里继续发挥作用”。所以我会把这套组合看成一个真正的工作台,而不只是几个能调模型的工具拼盘。
术语表
| 术语 | 在本文中的含义 |
|---|---|
| Agent | 任务中的角色,如 brains、planner、执行 agent |
| Agent Runtime | 承载 agent 执行的工具或环境,如 opencode、claude code |
| Multica / Brains | 指应用或系统本体 |
| Multica CLI / Brains CLI | 指它们各自的命令行入口 |
| CLI | 调用入口,如 multica ...、brains query ... |
| Daemon | 连接 Multica 和 agent runtime 的桥接层 |