当一个任务开始变复杂时,多开几个 Agent 可能是一个不错的选择。但多个 Agent 本身并不产生协作,你又得来回复制粘贴、检查和整合结果。没有明确的任务拆分、上下文隔离和验收条件,多个 Agent 会重复劳动,甚至把错误的判断一起放大。
我理解的 Agent Swarm,区别于 Multi-Agents —— 是由一组职责明确的 SubAgent 构成:它们各自拿到完成工作所需的最小上下文,使用匹配任务的模型,通过明确的输入输出进行协作。
它的前提是任务能够被拆分、并行和验证。
Agent Swarm 是什么
Agent Swarm 是一种任务系统:主 Agent 负责拆解和决策,SubAgent 在自己的边界内完成研究、实现或检查,最后由明确的验收条件决定哪些结果可以合并。它和“同时问几个 Agent”不同,协作关系、交付物和验收路径都需要提前定义。
最小版本需要三个角色:
- Planner:拆任务、标出依赖和验收条件。
- Builder:完成一个边界清晰的实现或分析任务。
- Reviewer:检查结果是否满足计划和项目约束。
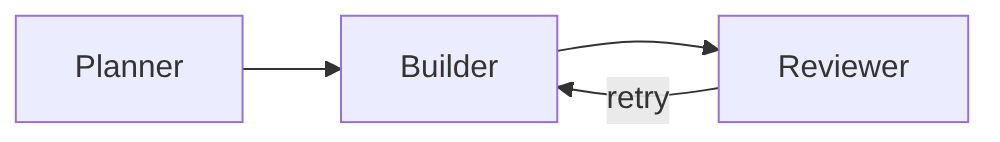
这个结构把计划、执行和验证拆开。Builder 可以专心把任务做完,Reviewer 可以保留挑战结果的立场,Planner 负责决定是否继续、重试或拆出新任务。
为什么需要 Swarm,以及什么时候不需要
判断是否需要 Swarm,关键不在任务大小,而在任务能否分成几个独立交付物。例如,重写一个服务时,可以并行盘点接口和依赖、研究目标模块边界;确认设计后,再进入实现、测试和架构审查。
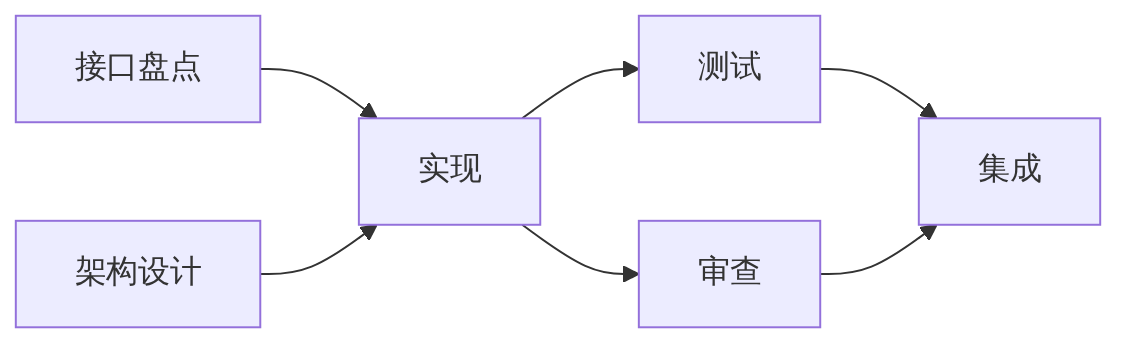
适合引入 SubAgent 的场景通常有三种信号:
- 子任务有单独的输入、输出和完成条件。
- 子任务之间没有前置依赖,或者依赖关系足够清楚。
- 每个结果可以单独测试、审查或用来源核验。
反过来,如果所有工作都要读同一批文件、修改同一个模块,或者任务目标还说不清楚,先用一个 Agent 把计划收敛更划算。此时加 Agent 只会增加沟通、合并和复核成本。
Swarm 不必成为默认架构。一个小改动、一次摘要、一个局部 bug,单 Agent 往往更快,且更容易追踪。只有独立工作流的收益大于协调成本时,拆分才有意义。
SubAgent 怎么构建:先给最小上下文
SubAgent 的第一价值是上下文隔离,速度提升排在后面。它不需要知道整个项目,只需要知道完成这一小块工作必须知道的事。
一个实用的任务契约包含五项:
- 目标:本次要完成什么。
- 范围:允许读取和修改什么。
- 约束:必须遵守哪些架构、风格或安全规则。
- 输入:上游已经确认的文件、事实或结论。
- 验收:什么结果才算完成。
例如,一个只读的架构审查 Agent 可以这样定义:
role: review-agent
goal: 检查本次变更是否违反模块依赖规则
scope:
  read:
    - src/
    - docs/architecture.md
  write: []
constraints:
  - 每条问题都要有文件位置和依据
output:
  - findings
  - evidence
  - verdict
YAML 只是表达接口的一种方式。主 Agent 应该能直接使用它的输出:改了哪些文件、运行了哪些检查、发现了什么问题、哪些结论仍然无法确认。“已经完成”或“看起来没问题”这类回复,不能直接进入下一步。
Skill 和 SubAgent 也要分开看。Skill 复用的是做法,比如测试、代码审查或资料研究;SubAgent 隔离的是责任、上下文和决策边界。同一个测试 Skill 可以同时提供给 Builder 和 Reviewer,但两者对“测试完成”的判断并不相同。
模型选择:按任务和风险分配,不要一把梭
给整个 Swarm 统一配置最强模型,看起来省心,实际会把成本和延迟同步放大。更好的做法是先按任务类型做静态绑定,再用完成耗时、重试次数和人工修正量验证配置是否合理。
| 任务 | 模型倾向 | 原因 | 示例 |
|---|---|---|---|
| 全仓分析、长文档梳理 | 长上下文模型 | 需要保留更多项目状态 | 🥇 Gemini 2.5 Pro(2M ctx) 🥈 Kimi K3(1M ctx) 🥉 DeepSeek V4 Pro(1M ctx) |
| 精确实现、局部重构 | 代码能力更强的模型 | 关注代码结构和逻辑 | 🥇 GPT-5.6 Sol(SWE 96.2%) 🥈 Claude Fable 5(SWE 95.0%) 🥉 DeepSeek V4 Pro(SWE ~80%) |
| 摘要、格式化、低风险整理 | 轻量模型 | 降低延迟和成本 | 🥇 Gemini 2.5 Flash-Lite 🥈 GPT-5.6 Luna 🥉 DeepSeek V4 Flash |
| 高风险决策、冲突仲裁 | 推理能力更强的模型 | 更适合处理歧义和反例 | 🥇 Claude Opus 5(推理链透明) 🥈 GPT-5.6 Sol(综合天花板) 🥉 DeepSeek V4 Pro(可审计) |
| 事实检索 | 能提供来源的检索能力 | 重点是可复核性 | 🥇 Gemini 2.5 Pro + Search grounding 🥈 GPT-5.6 Sol + Web Search 🥉 Kimi K3(内置联网) |
模型选择不能替代工程约束。强模型仍然会在模糊需求下生成看似合理的错误方案;轻量模型在范围清晰、输出格式固定的任务里,反而可能足够稳定。
效率、成本和收益
衡量 Swarm 效率时,应该看交付周期是否真的缩短。
它带来的效率主要来自两处:独立工作可以并行,主 Agent 不必在一个超长上下文里反复切换角色。代价则是:任务拆分、上下文准备、结果汇总、冲突处理和额外的模型调用都会增加成本。
因此,至少应该记录四个指标:
| 指标 | 要回答的问题 |
|---|---|
| 端到端耗时 | 从任务开始到可验收结果,是否真的更快? |
| 重试次数 | 哪个角色、模型或约束最容易失败? |
| 人工修正量 | 结果进入主线前,还需要改多少? |
| 总成本 | 并行调用带来的额外 token 和工具成本是否值得? |
收益通常不只体现在速度。清晰的任务契约会让结果更容易复查和交接;独立 Reviewer 能更早发现实现偏离;模型按任务分配后,也能把昂贵模型留给真正需要判断的节点。
但这些收益必须靠实际数据证明。对于一支团队来说,增加 Agent 是否减少端到端交付时间、降低返工,还是只是让日志变多,需要在自己的任务类型和代码库里测出来。
实践案例:Architect
我在使用 OpenCode 的过程中,为了适配不同类型的工作,创建一批 Custom Agent:explore 负责摸清代码库,coder 负责实现和测试,planner 负责把复杂目标拆成可执行计划(for Jira)。它们各有清楚的职责;再配上一批 Skills,高频工作不用每次都手打提示词。
这套工作流一开始很顺畅。任务来了,我根据阶段手动切到相应 Agent;复杂一点,就在主会话里指定“调用 explore 和 coder 并行处理”。随着效率和工作量的提升:每次都要我自己判断任务怎么拆、该找谁、哪几个可以同时开始,以及上一轮的结果是否已经够资格交给下一轮。特别是当我同时工作在好几个 Jira 任务上时,有些在编码、有些在调研、还有些在分析需求,手动切换的上下文管理和认知负载越来越高。
模型成本是另一个问题。刚开始时,我倾向于把强模型用在更多任务上。使用一段时间后发现,GPT-5.4 的输出往往比较长,用它处理小任务或直接写代码,响应速度和费用都不划算。于是我开始按角色绑定模型:默认模型处理主会话,轻量模型承担低风险、格式固定的工作,coder 使用代码专项模型,planner 使用更适合规划与调度的模型。
这一步没有让系统变得更聪明,但降低了成本并提高了吞吐量:该用强模型的地方保留质量,简单工作不再为冗长推理付费。
从手动调度到 Architect
我真正想解决的,是手动调度的重复劳动。
复杂任务里,我经常做的是同一套工作流:先判断任务有没有阻塞型歧义;没有的话,拆出可以并行的探索、研究或实现任务;等待结果;检查输出是否满足要求;再决定下一波任务。这个过程本身已经是一种编排,只是此前由我在对话中临时完成。
所以我创建了 Architect。我把它当作自己的分身:它负责原本由我完成的判断 —— 任务怎么拆、谁先做、谁可以并行、结果够不够进入下一轮。它不直接读文件、不写代码,职责只放在计划和委派上:根据任务依赖决定分几波派发,给每个 SubAgent 写清输入、目标和输出,并在每一波结束后检查结果。只有确认上一波的交付物达标,下一波才能开始。
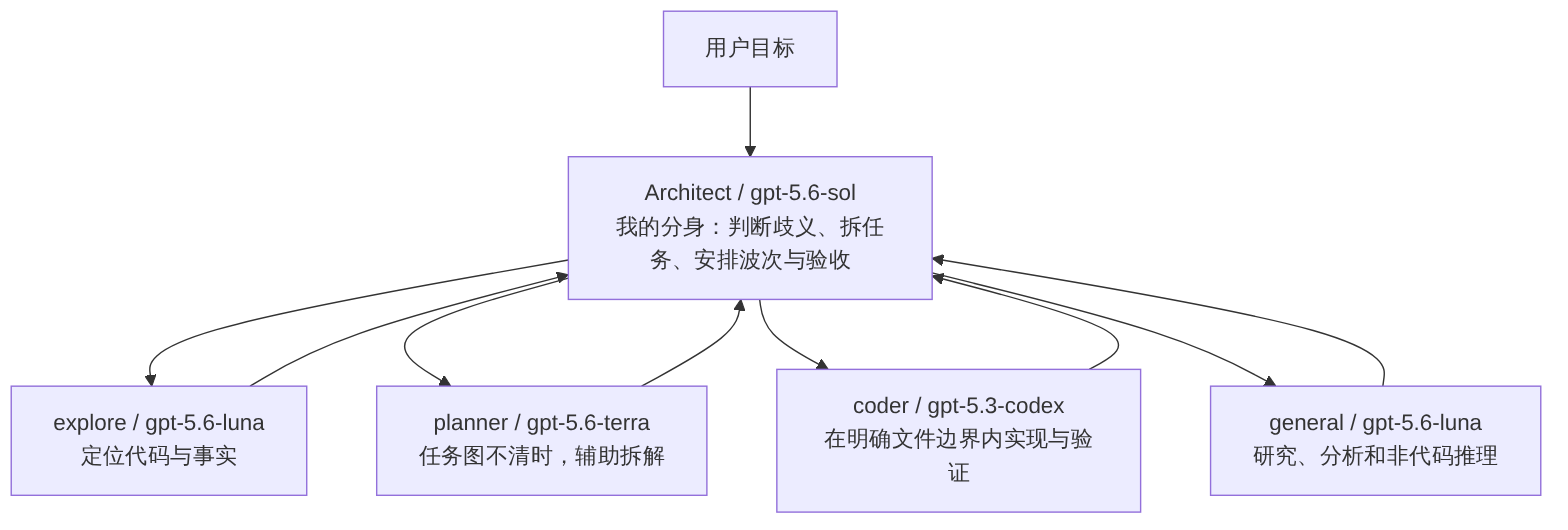
这张图描述的是当前的静态绑定,不代表模型能力的通用排名。绑定的目标是让每个角色先有稳定的默认选择,再根据成本、重试和人工修正持续调整。
关键在于把原本散在人工操作里的调度规则固化下来。比如:planner 只在任务依赖本身不清楚时使用,避免为了计划而计划;coder 并行时不能修改重叠文件;每个任务都必须给出自包含的输入和可验证的输出。
这也解释了 Architect 为什么不应该承担实现。它一边调度、一边读取代码或修改文件时,很容易重新变成一个上下文不断膨胀的主 Agent。把执行留给有清晰边界的 SubAgent,Architect 才能保留对依赖、冲突和验收的判断。
这套配置带来的边界
目前这套 Agent 仍然是一个可控的 Swarm 雏形,不是全自动的组织。它能把已经清楚的任务并行化,也能减少手动切换角色的次数;任务目标本身含糊、验收条件缺失时,Architect 仍然应该先停下来问,而不是把不确定性分发给更多 Agent。
需要持续观察的三件事:Architect(Orchestrator) 是否真的减少了端到端耗时;不同角色的模型绑定是否降低了重试和人工修正;以及编排本身新增的调用成本,是否小于它减少的沟通与返工。