我们有一个内部效率工具,是两年前做出来的。当时投入有限,后来又长期缺少稳定人力继续演进,技术债越积越多,开发和维护都变得越来越艰难。
它的上一版,花了一整个开发团队数月时间。这一次,在一个 agent engineer + 数个 agents 的协作下,大约一周就完成了主要功能重写、测试补齐和验证闭环。
一个直接的触发点,是看到 “Anthropic’s Bun Rust rewrite merged at speed of AI” 之后,对 agent 编码这件事有了新的认识:在 Agent 的帮助下,与其继续在一套债务缠身的老系统上“屎上雕花”,不如直接重写,从根源上解决问题。
重点并不在“agent 写代码有多快”,而在另一件事:agent 最大的价值,在于把项目管理、架构决策、代码实现和结果验证压进一个连续闭环。
如果没有这个闭环,agent 只会把已有问题放大。它能把正确路径放大,也能把错误设计、模糊需求和错误抽象更快地扩散出去。
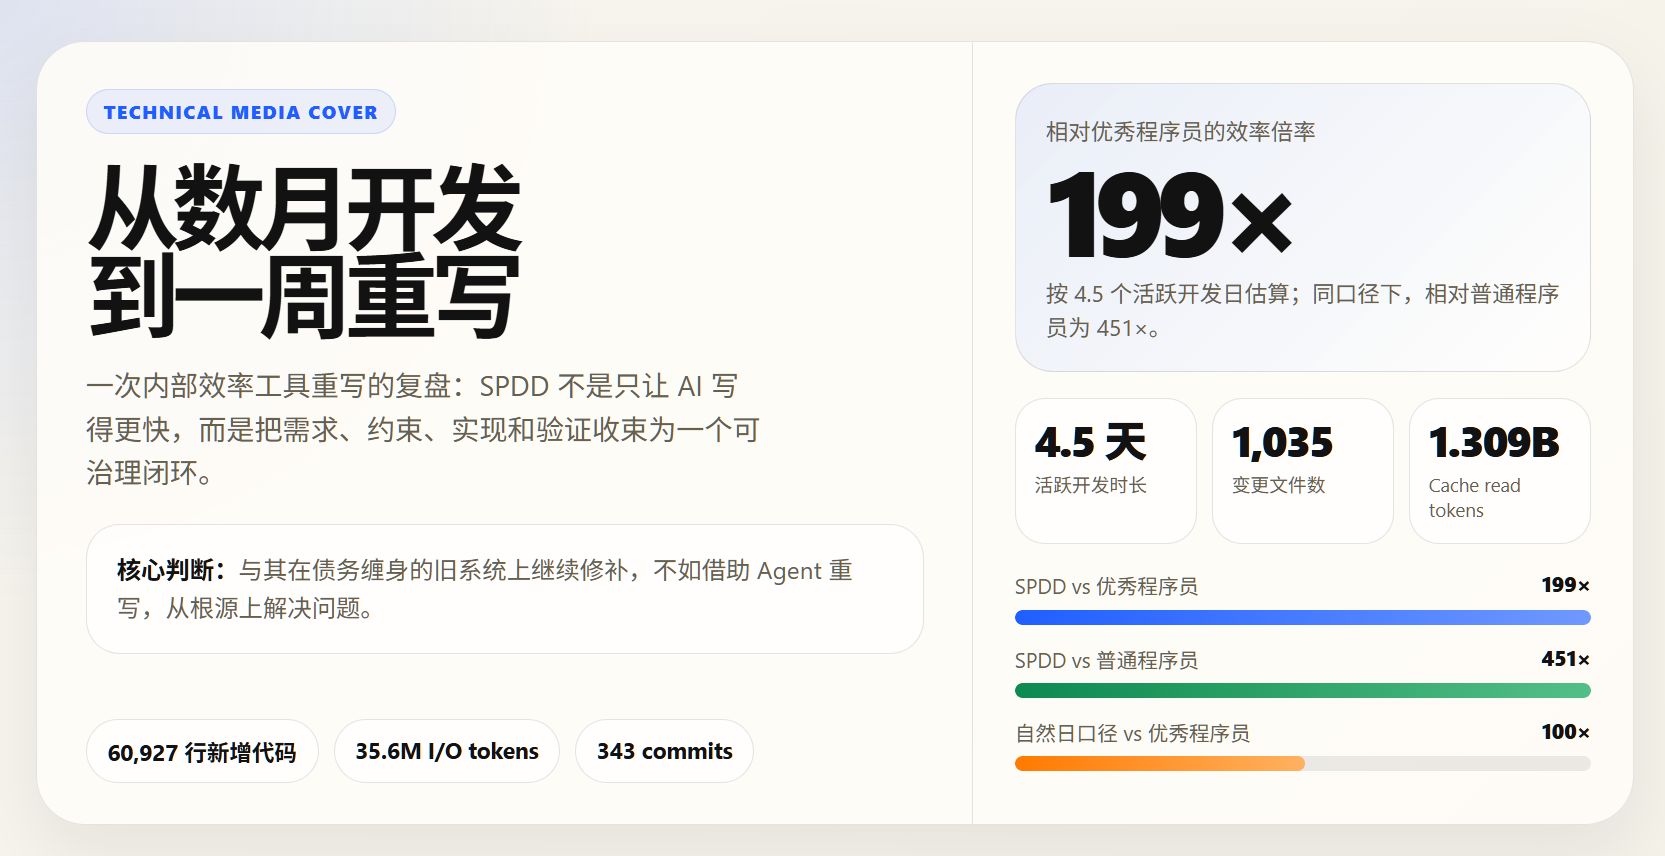
这次真正缩短的,不只是编码时间
这次的主力组合:模型主要用 gpt-5.3-codex,运行时主要用 OpenCode。
真正决定结果的,是项目一开始就先把治理骨架搭起来了。模型版本当然重要,但它不是这次的决定性因素。
一开始就用 mattpocock/skills 里的 grill-me,对 plan 做了多轮拷问;又参考 forrestchang/andrej-karpathy-skills 的 CLAUDE.md,单独做了一个 coder agent,作为 coding 阶段的 init prompt。
这两个动作的作用很直接:在开始写代码之前,先把问题定义、边界、步骤、非目标、风险和验证条件钉住。这样进入实现阶段时,agent 拿到的就是一套已经收敛过的执行前提。
所以这次被缩短的,不只是编码时间,而是需求澄清、方案来回拉扯、返工和架构漂移的时间。
Agent Coding 首先是项目治理问题
现在越来越确定,Agent Coding 在项目级别首先是“治理”问题,不只是“提效工具”问题。
这里说的治理,首先是把几件关键的事管住:
- 当前需求是否足够清晰
- 目标边界和非目标是否明确
- 每一步是否有可验证结果
- 偏差出现后,是否能被快速收敛成稳定约束
这也是为什么这次重构里,代码并不是最先写出来的东西。先行的是 plan、ADR、instruction、skill,以及把这些内容串起来的 CLAUDE.md。
在重写和重构场景里,这些东西往往比代码本身更稳定。代码是流动的,spec 才是控制面。谁先稳定,谁就应该拥有更高优先级。
和 agent 协作,前提是需求清晰且结果可验证
这次经验里最值得强调的边界条件,其实很朴素:agent 协作必须需求清晰,而且结果必须可验证。
如果需求本身高度模糊,或者完成条件说不清楚,agent 当然也能干活,但它更可能只是更快地把模糊实现出来。速度越快,返工越大。
所以,对 agent 项目的一个基本判断是:
- 执行前,要先做好需求分析和步骤拆解
- 执行中,要强制跑 TDD loop
- 执行后,要有强约束的 verification、checkpoint 和边界追问
这不是形式主义。agent 的代码产出速度太快了,人已经不可能只靠人工 review 来承担全部兜底责任。更多信心必须前移到约束、测试和验证上。
为什么这次几乎没有太多 revert
实现过程中不是完全没有问题,但确实很少出现大幅 revert。
原因很直接:前面那套 harness 已经把偏航空间压小了。agent 不是神奇地一次就写对了。
实际碰到的问题,更多是这类项目和这套预配置下容易出现的偏差,例如:
- 过度设计,比如过多的 factory、interface 抽象
- package 拆得过碎,局部整齐但整体可维护性下降
- 生成大量冗余代码和重复结构
这些问题不一定具有普适性,但它们说明了一件更通用的事:不能完全依赖,更不能直接放手给 agent。
因为 agent 一旦跑偏,破坏力和扩散能力也是成倍增加的。一个人写错一段代码,影响可能还是局部的;agent 如果在错误约束下高速生成,错误会很快扩散到多个包、多个抽象层和多条调用链里。
更关键的是,要有能力把偏差重新收敛成稳定约束,而不是等它扩散之后再回头修补。
偏差要回到架构决策,不要停在局部修补
这次最有价值的一点,是把偏差处理从“代码修补”提升到“架构治理”。
当我发现某类问题反复出现时,做法不是只改当下这几个文件,而是通过 architecture improve + grill-me 把问题重新压回 ADR:哪些抽象不该有,哪些边界需要收紧,哪些职责应该重新归位。然后再由 CLAUDE.md 统一索引这些 ADR,让它们成为后续编码时的稳定前提。
这样做的价值很明显:agent 不会在同一类问题上反复犯错。约束已经升级成了项目级规则,不再只是一次性的聊天上下文。
multi-agent 并行开发,前提不是更多 agent,而是更好的切分
很多人一谈 agent,就会自然想到 multi-agent。这里的看法更保守一点:multi-agent 只是 plan quality 的放大器。它不是起点。
如果总 plan 没有把 workstream、step、边界和 verification point 写清楚,多 agent 只会把混乱并行化。切片足够小、边界足够清楚时,多 agent、sub agents 和 git worktree 才会真正好用。
比较稳的方式是:
- 先用总 plan 定义目标边界、非目标和统一验收门槛
- 再把任务切成独立 workstream 和可执行 step
- 每一步只交付一个小而可验证的 slice
- 高风险任务放进独立 worktree
- 每完成一段就回到 verification 和 checkpoint
所以 multi-agent 的前提很明确:切分越清楚越好,不是 agent 越多越好。
TDD 是 agent coding 的必备项,不是可选项
在这次重构里,TDD 不是锦上添花,而是核心运行机制。
原因也很简单:agent 写代码的速度,已经快到人类无法只靠 review 保证细节正确性了。人更适合做需求判断、边界判断、风险判断和取舍判断。局部实现是否真的满足要求,必须更多依靠 tests 来回答。
所以在 agent coding 里,TDD 不只是“提升代码质量”的手段,它承担的是更基础的职责:
- 保证局部切片没有跑偏
- 保证分层职责没有塌掉
- 保证重构速度上来以后,正确性不会一起掉下去
- 保证最终的 verification 有可靠基础
如果说 SPDD 管的是“先定义清楚要做什么”,那 TDD 管的就是“做出来的东西到底算不算完成”。
token cost 真正该盯的是 cache IO
这次过程数据里还有一个很有意思的观察:整个重构过程中,大约消耗了 35M 的 I/O tokens、1.3B 的 cached tokens,对话规模到了 100+ sessions。
但实际 token 花费反而比我预期低得多。大多数 token 都走了 cache,整个过程里的返工也不多。
这背后其实就是两件事。重写天然会反复读取已有的大量代码和文档,所以 cached context 本来就高。持续更新的 ADR 和 plan 又提供了稳定而有效的上下文,agent 不需要反复猜需求、猜边界、猜实现方向,生成代码也更容易一开始就落在正确轨道上,返工自然会少很多。
所以真正该盯的,是上下文复用效率,以及这些上下文是否真的在提升正确性。表面的 prompt 长短没有那么重要。ADR、plan、instruction、skill 写得越清楚、更新得越及时,缓存和上下文复用的收益就越大,也越有机会把 token 消耗和返工一起压下来。
一份可直接执行的行动清单
如果要把这次经验压成一份能直接拿去用的清单,可以按下面这套顺序执行。
执行前
- 先做需求分析,不清楚的问题先澄清,不带着模糊需求进入 coding
- 先写 plan,明确边界、非目标、步骤和 verification 条件
- 用
grill-me反复追问 plan,直到主要风险和缺口被暴露出来 - 准备好 coder agent 的 init prompt,让编码阶段有稳定行为约束
- 明确哪些规则要进
CLAUDE.md、哪些要落 ADR、哪些要进 instruction
执行中
- 坚持 small, verifiable slices
- 强制跑 TDD loop,不要让实现先于测试失控扩张
- 需要并行时,先拆 workstream,再上 multi-agent
- 高风险改动放进独立 worktree,减少相互污染
- 发现偏差时,不只修代码,必要时升级成 ADR 和项目级约束
执行后
- 用强约束 verification 检查结果,而不是只看“代码写完了”
- 设 checkpoint,逐段确认目标是否真的达成
- 持续做边界追问:哪些抽象不该存在,哪些规则还没被固化
- 把新沉淀的约束回灌到
CLAUDE.md、ADR、plan 和 instruction
最后一句
这次最大的收获,不是“agent 终于能替开发写代码了”。我更确认了一件事:当 agent 成为主要执行单元之后,工程重点会前移到需求澄清、spec 设计、执行约束和结果验证。
从数月到一周,真正缩短的不是思考本身,而是那些原本散落在多人协作、反复沟通和返工里的损耗。前提很简单:先把项目治理这件事做好。